
实时换脸里的延迟,指的是你在摄像头前做出动作,到对应的AI处理画面真正显示出来之间的时间差。真正决定体感的不是某一个模型声称的推理时间,也不是 Speedtest 里的 ping,而是从摄像头到最终显示画面的整条链路。
在 Decart 的实时 SDK 中,这个指标叫 Glass-to-Glass Latency(G2G)。SDK 会在输入帧被采集时附带时间信息,让这个时间信息经过模型处理后继续传递,再和最终输出帧真正播放的时刻对应起来,从而估算一帧从“进入摄像头”到“出现在屏幕上”经历了多久。Decart 也明确区分了启动阶段的 ttffMs(Time to First Frame)和稳定运行阶段的 g2gMs。这比只看网络 RTT 更接近用户实际感受到的延迟,因为实时AI视频中,模型推理本身往往也是链路里的重要耗时。Decart SDK 的连接质量说明 对这个区别有更完整的解释。
G2G到底测量了什么?
先把几个经常混在一起的指标分开:
| 指标 | 它实际回答的问题 |
|---|---|
| Network RTT | 数据到远端再返回一次大约需要多久? |
| AI inference latency | AI模型处理输入需要多久? |
| FPS | 每秒能产生或显示多少帧? |
| Jitter | 延迟是否稳定,还是忽高忽低? |
| G2G latency | 摄像头中的动作多久以后真正出现在AI输出画面里? |
对实时换脸来说,G2G才是最接近最终体验的延迟指标。
例如网络 RTT 只有 30 ms,并不代表用户会在 30 ms 后看到AI结果。如果模型处理需要 200 ms,前后还有采集、编码、解码、渲染和缓冲,最终 G2G 仍然可能达到几百毫秒。
反过来也一样:只拿“模型单帧推理 100 ms”来代表整个实时换脸延迟也不准确,因为用户看到的结果还要经过完整的视频链路。
实时换脸的延迟来自哪里?
一条典型的云端实时换脸链路可以简化为:
Camera Capture → Frame Preparation → Video Encode → Uplink → Server / AI Inference → Output Encode → Downlink → Decode & Render → Display
桌面版如果还要把处理后的画面送进 OBS、Zoom 或其他软件,后面还会继续增加:
→ Virtual Camera → OBS / Zoom / Target App
这也是为什么排查实时换脸延迟时,不能只盯着“AI模型快不快”。整条链路上每个环节都可能增加一点时间,而最终 G2G 是这些环节共同作用的结果。
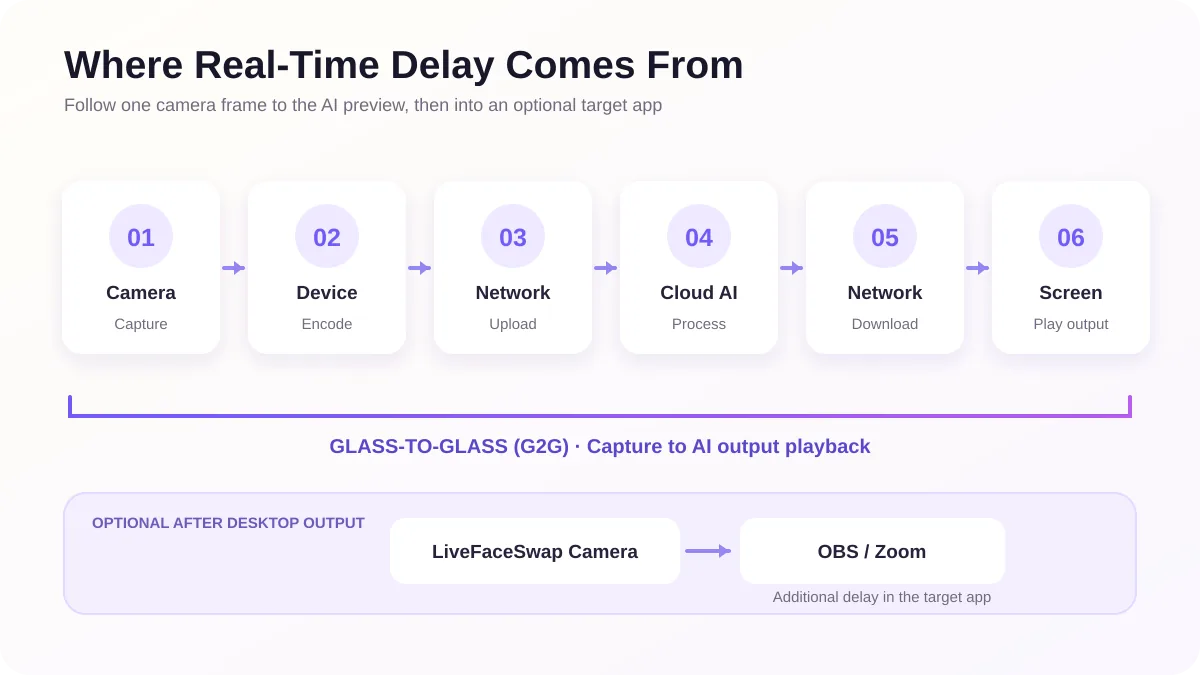
1. 摄像头采集本身就需要时间
摄像头并不是连续输出“无限多张画面”,而是按照一定帧率产生视频帧。
30 FPS 意味着平均每约 33.3 ms 出现一帧;24 FPS 则约为 41.7 ms 一帧。这个数字不是完整延迟,但它说明了一件事:在进入网络和AI之前,视频本身就已经有时间粒度。
实际采集还可能包含曝光、摄像头驱动、系统视频管线和 capture queue。如果某个环节为了稳定输出而缓存一两帧,延迟会继续增加。
2. 视频编码会增加延迟,但又不能省掉
原始摄像头画面数据量很大,实时传到云端前通常要先编码。WebRTC 会根据当前设置和网络情况,把画面压缩成适合实时传输的视频流。
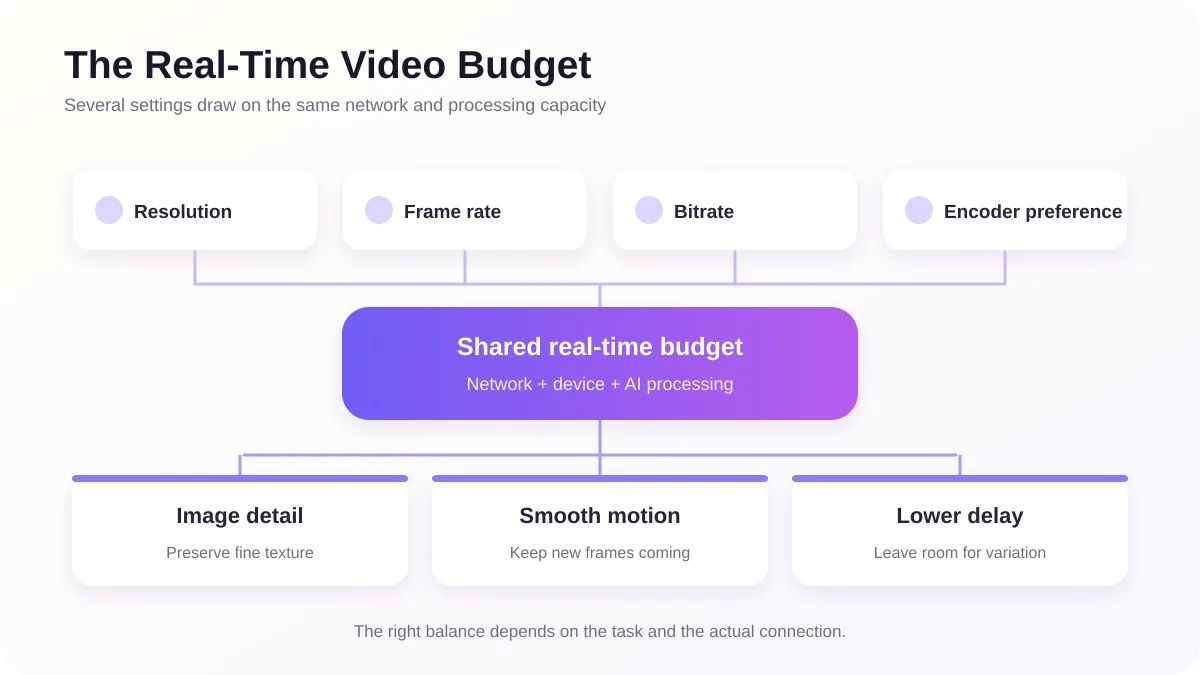
这里最重要的几个变量是:
- 分辨率;
- FPS;
- 码率(bitrate);
- 编码器对“细节”和“运动”的偏好。
分辨率更高,每帧包含的像素更多;FPS 更高,每秒需要编码和发送的帧更多;码率更高,通常可以保留更多视觉细节,但也要求网络有更充足、更稳定的上传能力。
3. 上行网络不仅看 Mbps,还看 RTT、Jitter 和丢包
实时换脸通常要先把摄像头画面发送到云端AI,所以上传链路非常重要。
很多人遇到卡顿时会先看 Speedtest,然后说“我有 100 Mbps,为什么还会慢?”问题在于,100 Mbps 主要说明吞吐能力,并不能保证实时传输稳定。
实时视频还很在意:
- RTT 是否够低;
- jitter 是否稳定;
- 是否存在 packet loss;
- 上传链路是否被其他任务占满;
- Wi-Fi 是否频繁重传;
- 路由器是否因为排队产生 bufferbloat。
Decart 的连接质量统计也不是只看带宽,而是综合 RTT、packet loss、available upstream bandwidth、FPS 等指标,并判断限制因素更像是 bandwidth、latency、loss、stall 还是 cpu。官方 SDK 采用这种方式,本质上也是因为“网速快”和“实时视频链路好”并不是一回事。
4. 服务端调度和AI推理是实时AI特有的重要环节
普通视频通话的主链路大致是:
Camera → Network → Other User
云端实时换脸则多了一段很重的处理:
Camera → Network → AI Model → Network → Output
服务器收到视频帧后,还可能经历队列、模型输入准备、AI推理、生成结果和输出处理。模型越复杂、负载越高,或者服务端排队越严重,这一段就可能越慢。
这也是 Decart 为什么要专门测 G2G,而不是只拿 RTT 判断体验。它在 SDK 文档中明确指出:network RTT 会忽略实时AI视频中的模型推理成本,因此网络状态看起来很好,实际画面仍可能明显滞后。
5. AI结果生成后,还要重新编码并传回来
模型算完并不等于用户已经看到了画面。输出还需要进入视频传输链路,再经过下行网络返回设备。
家庭网络通常下载带宽比上传更宽裕,但下行依然会受到拥塞、Wi-Fi 干扰、packet loss 和路由质量影响。如果接收端为了避免画面抖动增加缓冲,画面会更稳定,但也可能更晚出现。
6. 解码、渲染和播放器缓冲也会增加时间
设备收到远端视频数据后,还要解码、排队、交给浏览器或 Electron 渲染,再经过操作系统 compositor 显示到屏幕。
这里有一个实时视频里非常典型的权衡:
更大的 buffer 可以让播放更平稳,但会增加 latency;更激进地减少 buffer 可以降低 latency,但网络稍微抖一下就更容易卡顿或掉帧。
所以“最低延迟”和“最稳定播放”并不是完全相同的优化目标。
7. 虚拟摄像头和 OBS / Zoom 会让链路再变长
LiveFaceSwap 在线版的路径比较直接:
Camera → Cloud AI → Browser Output
桌面版如果要在 OBS、Zoom 或其他软件里使用处理后的画面,则会继续经过:
AI Output → LiveFaceSwap Camera → OBS / Zoom
虚拟摄像头本身不是第二个AI模型,但它需要把处理后的画面作为新的摄像头视频源交给目标软件。OBS 或视频通话软件又可能继续做 resize、buffer、encode 或 compositing。
因此,LiveFaceSwap 自己预览窗口里的延迟,不一定等于 OBS 或 Zoom 最终看到的总延迟。 如果 LiveFaceSwap 预览已经很跟手,但 OBS 里的画面明显更慢,排查重点应该放在虚拟摄像头之后,而不是重新怀疑前面的AI推理。
如果你想了解虚拟摄像头在这条链路里的具体位置,可以继续看 LiveFaceSwap 虚拟摄像头说明。
一个延迟预算:为什么每一段都不算慢,最后还是会明显滞后?
端到端延迟最容易被低估,因为很多小延迟会累加起来。
下面只是一个用于理解链路的示意计算,不是 LiveFaceSwap 的实测或保证值:
| 环节 | 示例耗时 |
|---|---|
| Camera capture | 20–40 ms |
| Encode | 10–25 ms |
| Uplink / transport | 20–70 ms |
| Server + AI processing | 120–250+ ms |
| Downlink / transport | 20–70 ms |
| Decode + render | 15–40 ms |
| Virtual camera / target app | 10–80+ ms |
如果取一组中间值:
30 + 15 + 40 + 200 + 40 + 25 + 50 = 400 ms
没有哪一段看起来特别夸张,但用户最终看到的画面已经可能落后真实动作约 0.4 秒。
实际系统还会通过 pipeline 并行处理不同帧,所以不能把这张表理解成每一帧一定严格串行执行。它的意义是说明:G2G关注的是完整链路,而不是某一项 benchmark。
FPS和G2G延迟不是一回事
这两个概念很容易混淆。
FPS 告诉你新画面多久来一张;G2G 告诉你看到这张画面时,它距离摄像头采集那一刻已经过去多久。
因此完全可能出现:
- 30 FPS + 500 ms G2G:画面很顺,但始终比你的真实动作晚半秒;
- 15 FPS + 150 ms G2G:响应更快,但动作显得不够流畅。
这就是为什么“30 FPS 大约每 33 ms 一帧”不能推导出“整个系统只有 33 ms 延迟”。实时系统可以同时处理多帧:一帧在AI推理时,下一帧已经在上传,再下一帧可能正在摄像头采集。
对于实时换脸,体验至少要同时看四件事:
Latency + FPS + Jitter + Dropped Frames
只追求其中一个数字,很容易把系统优化到另一个方向变差。
为什么更清晰的画面可能带来更高延迟?
清晰度、流畅度和低延迟之间没有完全免费的组合。
更高分辨率意味着更多数据和处理量
从 720p 提升到更高分辨率,每帧需要处理的像素明显增加。摄像头采集、视频编码、网络传输、解码和渲染的工作量都会受到影响;如果AI模型的输入或输出也随分辨率增加,服务端计算量同样可能变化。
分辨率提高后,如果仍希望保留相同的视觉质量,通常还需要更高的码率。
更高码率能保留细节,但需要更大的网络余量
码率过低时,脸部边缘、头发、皮肤纹理和快速运动区域更容易出现压缩损失。
但把码率无限调高也不是答案。如果上传链路只剩很少余量,短时间的网络波动就可能把发送队列堆起来,带来 jitter、packet loss 或额外 buffering,最后反而增加延迟。
因此实时视频通常更希望:码率稳定地低于网络真实可用能力,而不是长期顶着带宽上限运行。
编码器也会在“运动流畅”和“细节清晰”之间做选择
LiveFaceSwap 当前接入的 XMAX SDK 1.1.10 就把这个权衡明确暴露成 contentHint:
motion:运动流畅度优先,适合摄像头、视频、电影或游戏类画面;detail:细节清晰度优先,适合需要保留图片、文字和复杂纹理的画面;text:文字清晰度优先。
它的实时 RTC stream 还能单独控制 width、height、fps 和 maxKbps。当前 SDK 的默认摄像头配置是:桌面端 1472 × 832 @ 24 fps,移动端 960 × 1280 @ 24 fps,最大编码码率默认 1200 Kbps,默认 contentHint 为 detail。
这说明实时视频的“质量”本身就不是一个单一旋钮。你可以把更多资源给细节,也可以让编码器更偏向运动流畅;可以提高分辨率,也可以保留更多网络余量来换取稳定性。
LiveFaceSwap 当前并没有把 XMAX 的
motion / detail / text做成面向用户的切换按钮。这里引用 SDK 配置,是为了说明实时视频编码器内部确实存在这种取舍,而不是介绍一个当前可操作的产品功能。
实时换脸到底需要多快的网络?
这个问题不能只给一个“至少多少 Mbps”的绝对答案,因为不同模型、分辨率、编码策略和网络环境都会改变带宽需求。
但可以用当前 XMAX SDK 的实时摄像头默认值做一个工程参考:它的 RTC 最大编码码率默认是 1200 Kbps,也就是视频上行编码目标上限大约 1.2 Mbps。RTC 会根据网络和设备状态,在这个上限以内动态调整实际发送码率。
这不代表 1.2 Mbps 上传网络就足够。 实际网络还需要为协议开销、码率波动、音频、丢包恢复以及同一网络里的其他流量留余量。
如果只考虑一条类似当前 XMAX 默认配置的实时AI视频链路,可以把下面的数字理解为经验上的网络余量,而不是官方最低要求:
| 稳定上传能力 | 更合理的理解 |
|---|---|
| 约 3 Mbps | 有可能运行,但网络余量较小,遇到波动更容易影响实时性 |
| 5 Mbps 以上 | 对约 1.2 Mbps 的实时视频上行有更合理的余量 |
| 10 Mbps 以上 | 如果还要同时运行 OBS、视频通话、直播或其他网络任务,会更从容 |
真正重要的是“stable upload”。稳定的 5 Mbps 上传,往往比一个测速能跑到 100 Mbps、但 jitter 和丢包很严重的 Wi-Fi 更适合实时AI视频。
如果同时还要用 OBS 向直播平台推流,需要把 OBS 自己的上传码率也算进去。例如实时换脸上行本身需要一部分带宽,OBS 又需要几 Mbps 的直播码率,那么总上传需求就不再只是 LiveFaceSwap 这一条流。
为什么测速很快的Wi-Fi仍然可能有明显延迟?
Speedtest 更接近回答“这条网络一段时间内能吞吐多少数据”,实时换脸还在问另一个问题:“每一小段视频数据能不能持续、稳定、及时地到达?”
几个常见情况都可能让高速网络出现很差的实时体验:
- 2.4 GHz Wi-Fi 环境拥挤,重传很多;
- 上传任务把路由器队列长期塞满;
- 网络存在明显 bufferbloat,空闲时 ping 很低,一上传就突然升到几百毫秒;
- VPN 或跨区域路由增加 RTT;
- 网络偶尔丢包,为了恢复画面产生更多等待;
- 带宽虽然高,但 jitter 很大,接收端不得不增加 buffer 来保证连续播放。
当带宽已经足够后,对 realtime AI 来说,稳定的低延迟通常比测速页面上的峰值 Mbps 更重要。
如何降低实时换脸延迟?
最有效的方法不是一次改十个设置,而是先判断延迟从链路的哪一段开始出现。
先看 LiveFaceSwap 自己的AI预览
如果 LiveFaceSwap 的 AI preview 本身已经明显落后你的动作,问题更可能位于前半段:
Camera → Encode → Network → Cloud AI → Return → Preview
这时优先检查:
- 网络 RTT、jitter 和 packet loss;
- 是否正在进行大文件上传;
- Wi-Fi 是否稳定;
- 是否经过 VPN;
- 当前分辨率、FPS 和发送码率是否超过网络或设备能稳定承担的范围;
- 服务端或模型本身是否出现处理延迟。
如果 LiveFaceSwap 预览正常,但 OBS / Zoom 慢
那就不要先去怀疑云端AI。
这意味着前面的 G2G 已经相对正常,新增的延迟更可能来自:
LiveFaceSwap Output → Virtual Camera → OBS / Zoom → Further Encode / Buffer
检查 OBS 的视频分辨率、FPS、滤镜、渲染负载和输出设置,或者看看目标软件是否又增加了一层视频处理和 buffer。
给网络留余量,而不是把码率顶满
实时视频最怕长期处在链路极限上。即使平均带宽勉强够,只要出现一点波动,队列就会开始积压。
如果系统支持调整分辨率或码率,降低一点视觉负载通常比让网络持续满载更容易得到稳定的实时体验。
直播和视频通话优先保证运动连续性
对于直播、视频通话和摄像头互动,人的注意力通常会更快察觉动作跟不上、嘴型落后和画面一顿一顿,而不是停下来检查每一根头发的细节。
这也是 XMAX SDK 为什么提供 motion 和 detail 两种不同编码倾向。它们代表的不是“好画质”和“坏画质”,而是在有限的实时预算里,把资源优先给不同目标。
减少不必要的视频处理环节
链路越长,潜在的 queue、buffer、resize、encode 和 decode 就越多。
如果只是测试AI响应速度,直接看 LiveFaceSwap preview 最容易判断前半段链路。如果最终目标是 OBS,则再单独测试虚拟摄像头和 OBS 这一段。这样可以避免把所有延迟都笼统归因到“AI太慢”。
为什么只看Ping不够?
Ping 或 WebRTC RTT 能告诉你网络往返时间,但实时AI换脸真正关心的是一帧从采集到最终显示经历了多久。
Decart 的 JavaScript SDK 会在浏览器支持相关 frame metadata 能力时自动跟踪输入帧时间,让时间信息经过服务端推理后继续保留,并在输出真正播放时计算 G2G。它还提供 deep connectivity probe:不是只测试 STUN / RTT,而是短暂建立真实 realtime session,用 synthetic source 实际测量 G2G,再关闭连接。Decart SDK 把这种检测作为独立能力,就是因为网络测通并不等于实时AI链路足够快。
如果需要分析一个实时换脸系统,最有价值的问题不是:
我的 ping 是多少?
而是:
从摄像头采集,到AI结果真正显示出来,整条 G2G 链路用了多少时间?其中哪一段占得最多?
理解这个问题之后,分辨率、FPS、码率、网络、AI推理和虚拟摄像头之间的关系就清楚了:降低实时换脸延迟,不是单纯追求某一个更快的数字,而是在整条链路里减少不必要的等待,同时给网络和视频处理留下足够的稳定余量。
如果你还想继续了解实时换脸内部如何处理每一帧,可以看 实时换脸是如何工作的?;如果你更关心云端和本地处理在延迟、硬件和网络上的差异,可以继续看 云端 vs 本地实时换脸。