
实时换脸不是先生成一张换脸图片,再让它“动起来”。它会随着摄像头不断产生新画面,持续理解你现在的姿态和表情,再把参考人物的身份生成到当前画面里。这个过程会一帧接一帧地重复,所以真正困难的不只是“这一帧像不像”,还包括下一帧能不能及时生成、前后画面能不能保持稳定。
可以先把整个过程理解成:
摄像头画面 → 理解人脸 → 加入参考身份 → 生成新画面 → 融合 → 输出 → 继续处理下一帧
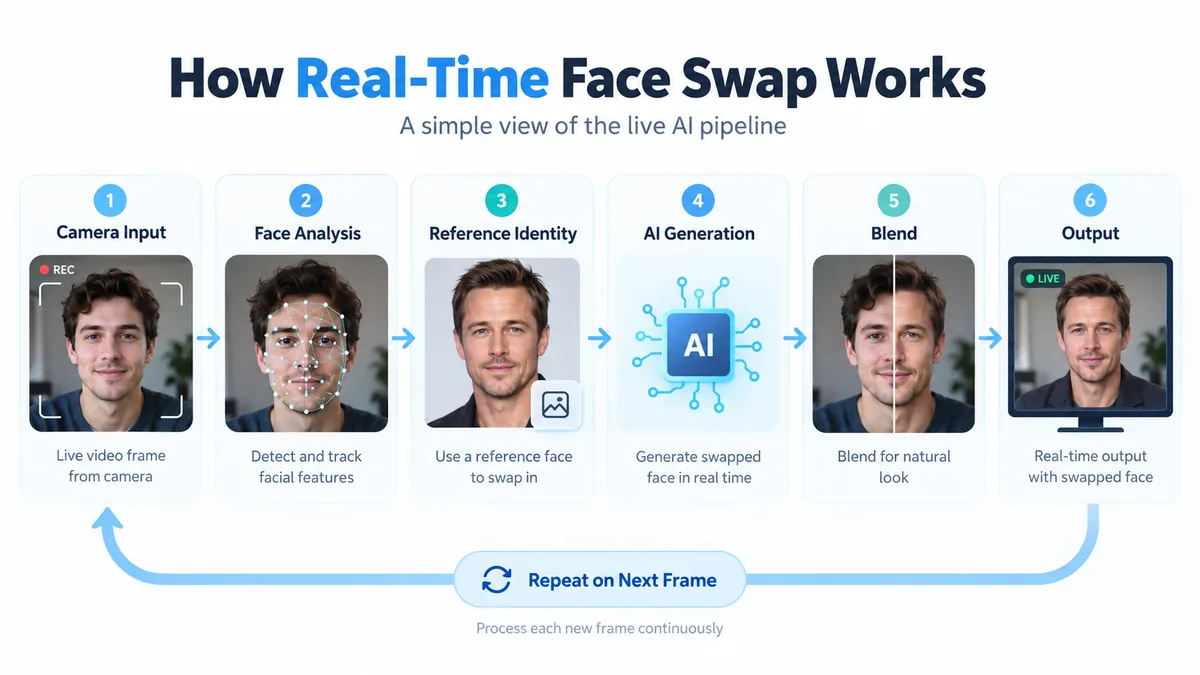
实时换脸其实在不断处理一帧又一帧的画面
摄像头不是一次只交给AI一张图片,而是在持续产生视频帧。实时换脸系统需要不断接收这些新画面,并在足够短的时间内完成处理,再把结果显示出来。
这也是实时换脸和普通照片换脸最大的技术差别之一。照片换脸只需要让最终那一张图片看起来正确;实时视频则需要在你说话、转头、眨眼或者靠近镜头时,持续更新结果。
从用户视角看,画面像是在连续变化;从系统视角看,它更像是在不断回答同一个问题:这一刻镜头里发生了什么,换成目标人物之后应该是什么样子?
AI首先要知道你的脸在哪里,以及现在是什么状态
生成之前,系统要先理解当前摄像头画面。
它通常需要判断:
- 画面里有没有脸;
- 脸在什么位置、大概有多大;
- 头部朝向哪里;
- 眼睛、鼻子、嘴和脸部轮廓大致在哪里;
- 当前是微笑、张嘴、转头,还是其他表情和姿态。
这些信息的目的不是给脸贴上一组“标记点”,而是让后面的AI知道当前画面应该保持什么动作。
比如你从正面慢慢转向侧面,系统不能一直生成一张正脸;你张嘴说话时,输出里的嘴部也不能保持不动。头部角度越极端,或者脸被手、头发、麦克风遮挡得越多,需要理解的有效信息就越少,处理也会更难。
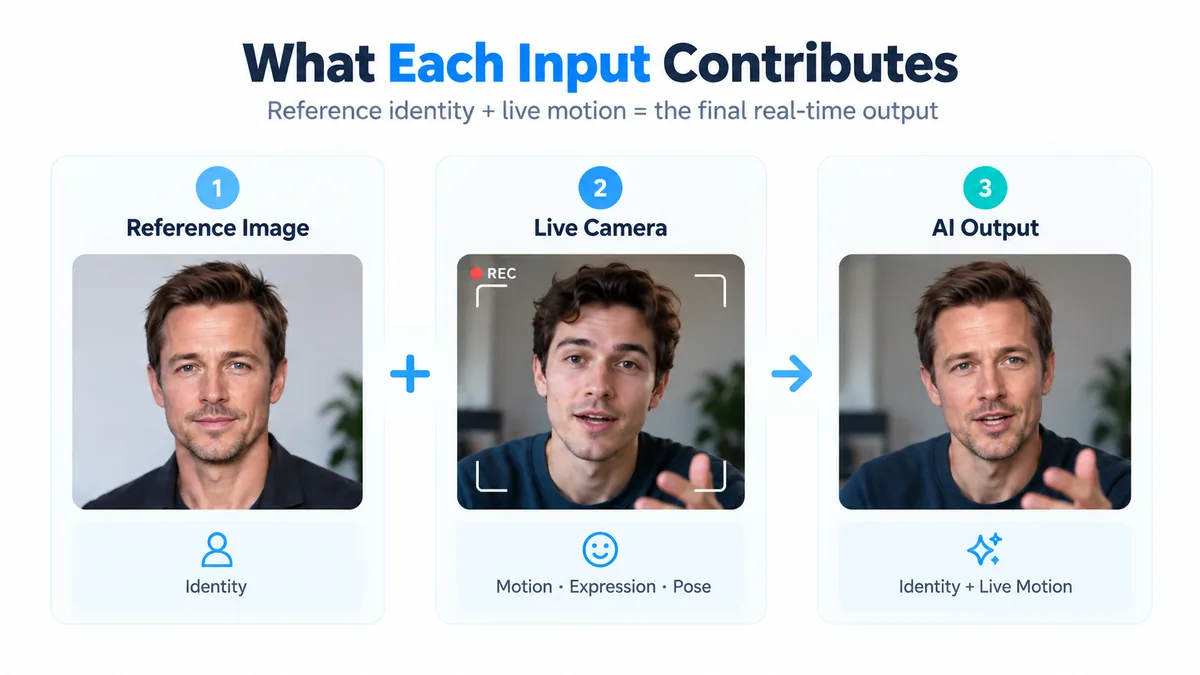
参考图决定“你要变成谁”,摄像头决定“这个人现在在做什么”
这是理解实时换脸最简单的一种方式。
参考图主要提供身份和外观信息;实时摄像头主要提供当前的动作、表情、姿态和画面环境。 AI把这两部分信息组合起来,生成新的实时画面。
例如,你上传一张目标人物的参考图,然后自己在摄像头前微笑、转头或者说话。理想情况下,输出仍然跟随你的动作,但画面里呈现的是参考人物的身份和外观。
Decart 在 Lucy 2.1 的官方文档 中用了一个很直观的说法:参考图是视觉身份目标,实时视频提供动作、表情和姿态,模型再把两者结合起来。这个解释也适合用来理解实时换脸的核心输入关系。
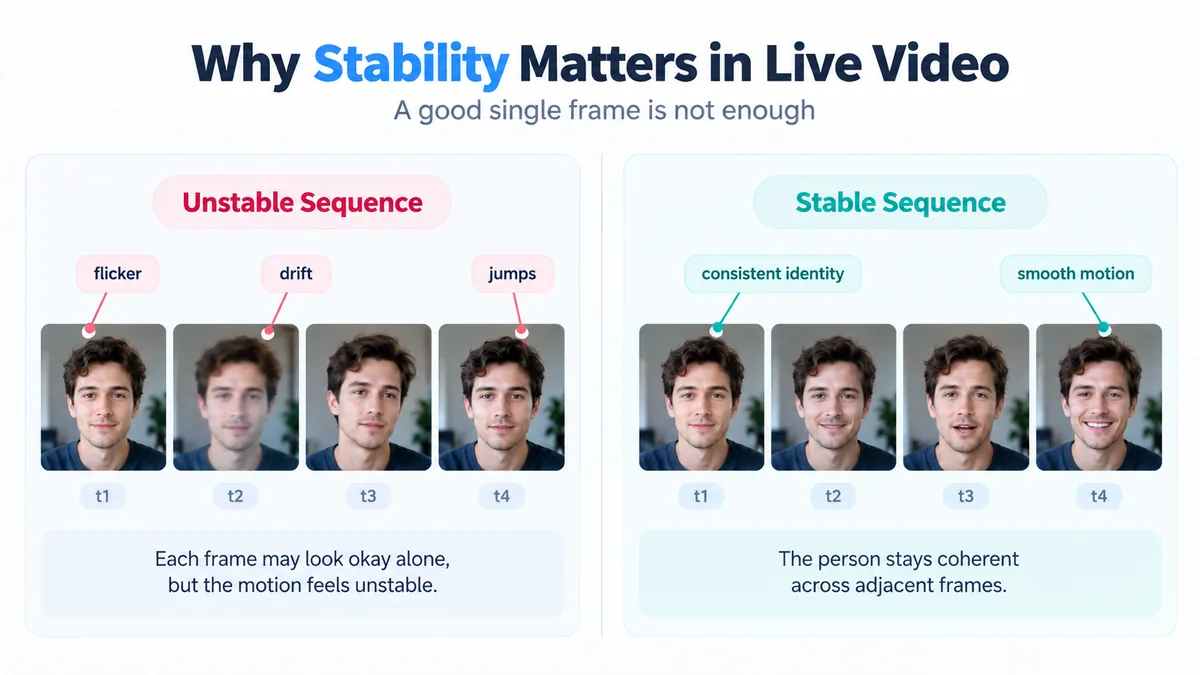
为什么换好一帧还不够:视频必须让前后画面保持一致
一张静态图片只需要这一帧看起来正确。实时视频还多了一层要求:前一帧、这一帧和下一帧之间必须看起来像同一个连续的人。
如果模型每一帧都能生成一张不错的脸,但相邻帧之间差异太大,播放起来仍然会很不自然。常见表现包括:
- 脸部边缘来回闪动;
- 人物身份在不同帧里轻微漂移;
- 某些角度突然变得不像参考人物;
- 表情切换时出现短暂的重影或跳变。
在技术上,这类问题通常归到一个概念:时间一致性(temporal consistency)。
它也是实时视频模型和单张图片模型差异很大的地方。Decart 在 Lucy 2.5 的公开说明 中,把更强的 temporal consistency 和更低延迟并列为实时视频模型的重要改进方向。换句话说,实时视频的质量不只是“每张图有多漂亮”,还包括连续播放时能不能稳定。
生成的新脸还需要重新融入原来的画面
AI生成出目标人物的脸部区域后,还不能直接把它像贴纸一样盖回摄像头画面。
系统还需要处理生成区域和原画面的关系,例如:
- 脸颊、下巴和额头的边界是否自然;
- 原来的光线和肤色能不能接得上;
- 手、头发、眼镜或其他物体经过脸部时,前后关系是否合理;
- 人物移动时,生成区域会不会和原画面脱节。
这一步通常被概括为 blending 或 compositing。对普通用户来说,不需要记住具体算法,只需要知道:“生成出一张脸”和“让这张脸自然地存在于当前视频里”是两个不同的问题。
实时换脸为什么必须在画质和速度之间做取舍?
普通图片生成可以多花一点时间换取更复杂的计算,但实时视频没有这么宽松。
一帧画面从摄像头出现到你真正看到AI结果,中间可能还要经历采集、编码、网络传输、AI推理、解码和显示。桌面软件再把画面送进其他应用时,还可能多一层虚拟摄像头和目标软件的缓冲。
因此实时系统真正追求的通常不是物理意义上的“零延迟”,而是:在足够短、足够稳定的端到端延迟下,持续生成质量足够好的画面。
所以,模型更复杂并不一定意味着实时体验更好。如果单帧更精细,但每一帧都要等太久,画面就会跟不上人的动作;如果只追求速度,又可能牺牲身份相似度、细节或者稳定性。
Decart 的 Research 页面 会直接把 frames per second 和 latency 作为实时模型的重要性能指标,这也说明实时AI的评价标准和离线图片生成并不完全相同。
稍微深入一点:实时AI视频模型到底难在哪里?
如果只想理解实时换脸怎么工作,前面的内容已经足够。再往技术方向多走一步,可以把难点归结成三件事。
它不是一次生成,而是持续生成
模型必须持续接收新的摄像头输入,并不断产生新的输出。任何一个环节持续变慢,最后都会表现为延迟、掉帧或者画面跟不上动作。
它不能只关心当前这一帧
假如每一帧都完全独立地追求“这张图最好看”,连续起来反而可能不停变化。实时视频除了当前帧质量,还需要控制相邻帧之间的身份、结构和运动连续性。
每一帧都有时间预算
如果最终视频以30 FPS显示,一秒钟里就需要呈现大约30帧,平均每帧对应约33毫秒的显示时间尺度。实际系统还会使用流水线、缓冲和并行处理,所以这并不等于“所有计算必须在33毫秒内完成”。这个数字只是帮助理解:实时模型的计算时间预算非常紧,效率和延迟会直接影响体验。
Decart 的 Lucy 页面公开强调 continuous generation、FPS 和低延迟,也是同一个原因:实时视频模型最终要在单帧质量、跨帧稳定性、计算量和响应速度之间同时取得平衡。
处理后的实时画面最后去了哪里?
模型生成的画面最终还要回到用户真正会看到或使用它的地方。
在 LiveFaceSwap 在线版里,流程可以简单理解成:
Camera → Cloud AI → Browser Output
摄像头画面经过云端AI处理后,结果返回浏览器中持续显示。
桌面版除了预览,还可以把处理后的结果通过 LiveFaceSwap Camera 虚拟摄像头送给兼容的软件,例如 OBS 或 Zoom。这里不需要把虚拟摄像头理解成第二个AI模型,它更像是一个“输出接口”,让其他软件把处理后的画面当成摄像头输入。
如果你想继续了解这一部分,可以看 LiveFaceSwap 虚拟摄像头说明。
为什么参考图、摄像头和光线仍然会影响结果?
AI并不是脱离输入独立工作的。
参考图提供目标人物信息,摄像头提供当前姿态、表情和环境。输入越清晰、稳定,系统越容易判断“谁应该被生成”和“这一刻应该怎么动”。
因此下面这些条件通常会直接影响实时结果:
- 参考图里人物是否清楚、脸部是否容易辨认;
- 摄像头画面是否清晰;
- 光线是否稳定;
- 脸是否长期处于极端侧面或被大面积遮挡;
- 网络和整个处理链路是否稳定。
硬件要求则取决于系统是把主要AI计算放在本地还是云端。LiveFaceSwap 使用云端实时AI处理,所以本地不需要为了AI推理准备高性能独立显卡。这个问题可以继续看 实时AI换脸需要显卡吗?。
如果你已经理解原理,想实际开始使用,可以继续看 如何进行实时换脸:完整指南。