
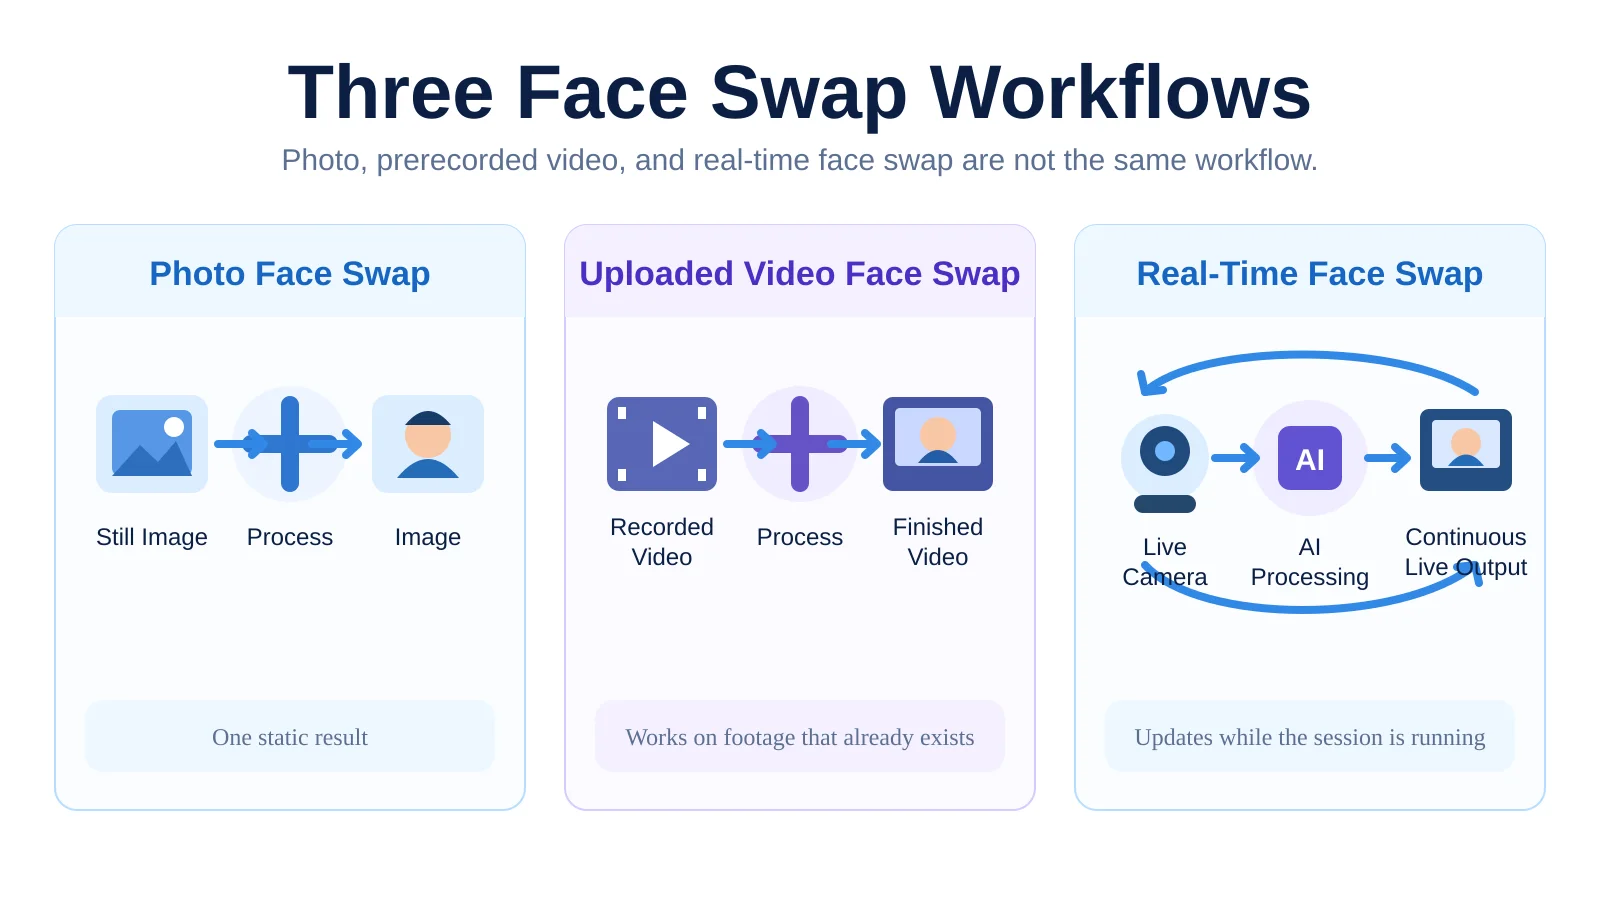
照片换脸、上传视频换脸和实时换脸都属于“换脸”,但它们其实是三种不同的工作流。 照片换脸只需要处理一张静态图片,上传视频换脸处理的是已经录好的素材,而实时换脸必须在摄像头还在运行时持续生成结果。
本文里的“传统换脸”主要指前两种:照片换脸和上传视频换脸。它们和实时换脸最大的区别,不只是输入格式不同,而是处理发生在什么时候,以及系统有多少时间得到结果。
照片、视频和实时换脸,其实是三种不同的工作流
最简单的区分方式,是看AI拿到的素材是什么,以及结果什么时候出来。
| 对比项 | 照片换脸 | 上传视频换脸 | 实时换脸 |
|---|---|---|---|
| 输入 | 静态图片 | 已录制视频 | 实时摄像头画面 |
| 输出 | 一张图片 | 一段处理完成的视频 | 持续变化的视频流 |
| 结果什么时候出现 | 处理后 | 整段或一段素材处理后 | 边运行边生成 |
| 是否需要跟随动作 | 不需要 | 需要 | 需要,而且必须及时跟上 |
| 延迟是否重要 | 基本不重要 | 通常不是核心问题 | 非常重要 |
| 常见用途 | 图片编辑、头像、趣味内容 | 视频后期、成片制作 | 直播、视频通话、实时创作 |
照片换脸最简单:给系统一张图片和参考人物,最终只需要生成一张结果图。
上传视频换脸已经复杂很多,因为人物会说话、转头、改变表情,前后画面还需要保持稳定。但系统面对的是一段已经存在的视频,可以在录制结束之后处理。
实时换脸则完全不同。摄像头还在不断产生新画面,系统必须一边接收输入,一边处理并返回新的结果。
传统换脸本身也不只有一种技术
“传统换脸”并不等于“传统AI换脸”。照片和录制视频中的人脸替换,在不同年代、不同工具里可以用完全不同的技术实现。
一种比较经典的做法并不需要生成式AI。系统先识别人脸位置和关键点,例如眼睛、鼻子、嘴巴和脸部轮廓,再把另一张脸进行缩放、旋转或形变,使它和目标人物对齐,最后通过遮罩、颜色匹配和边缘融合把两张画面合在一起。
这类方法更接近:
检测人脸 → 对齐五官 → 变形或替换脸部区域 → 融合回原画面
例如,OpenCV 的 seamlessClone 就是典型的局部区域融合工具;开源项目 wuhuikai/FaceSwap 则直接使用 OpenCV 和 dlib 完成人脸对齐、颜色校正和图像融合,也提供图片、视频和摄像头示例。它们都能帮助理解:换脸并不一定意味着重新“生成”一个人物,也可以是在识别人脸之后,对现有图像区域做几何变形、替换和合成。
另一类则是现在更常见的AI换脸。模型会学习或提取人物身份特征,再根据目标画面中的姿态、表情和光线生成或重建新的脸部区域。经典开源项目 Faceswap 就采用深度学习训练模型来处理图片和视频;较新的 FaceFusion 则把多种现代人脸处理能力整合在同一个项目里。不同方案的模型结构和工作流并不相同,但目标都是让身份替换比简单贴图更自然,并更好地适应表情、角度和光线变化。
所以,“照片换脸”和“上传视频换脸”描述的是输入和工作流;“传统图像处理”还是“AI模型”描述的则是内部使用什么技术。这两个维度不要混在一起。
真正的区别在于:处理发生在什么时候
“上传视频换脸”和“实时换脸”都要处理连续画面,所以看起来很像。但真正决定体验的,是处理发生在事情结束之后,还是事情正在发生的时候。
上传视频换脸通常是:
录制视频 → 上传 → 等待处理 → 查看或下载结果
如果一段一分钟的视频需要几分钟处理,只要最终成片符合要求,这个工作流仍然可以正常使用。
实时换脸没有这样的等待空间。它更接近:
摄像头输入 → AI处理 → 立即显示结果 → 接收下一批画面 → 继续处理
你转头、张嘴或改变表情以后,结果需要很快跟着变化。否则即使某一帧单独看起来很好,整个体验仍然会显得迟钝。
所以,能处理视频不等于能处理实时摄像头。 对直播、视频通话和现场互动来说,结果必须在互动发生时就可用,而不是录制结束几分钟以后才出现。
如果你想继续了解实时系统内部如何持续处理摄像头画面,可以看实时换脸是如何工作的?。
实时换脸和传统换脸分别适合什么场景
它们解决的其实不是同一个任务,所以没有必要把其中一种理解成另一种的“升级版”。
照片换脸更适合一次性的静态结果,比如头像、图片编辑、趣味图片或快速视觉实验。你只关心最终那一张图,不需要系统跟随动作。
上传视频换脸更适合已经拍好的内容。比如一段短视频、广告素材或其他需要后期处理的成片。重点是最后的视频效果,而不是生成过程中能不能立刻看到结果。
实时换脸更适合结果必须跟着人一起变化的场景。例如:
- 直播时让角色跟随主播的表情和动作;
- 视频通话中把AI画面作为摄像头输入;
- 录制内容时边表演边观察结果;
- 在现场演示或互动体验中立即切换不同人物或视觉效果。
实时工作流还有一个很直接的优势:反馈是即时的。如果某个角度、表情或参考图效果不好,可以当场调整,而不是等整段视频处理完之后才发现问题。
更多实际场景可以看现在的实时换脸可以用来做什么?。
为什么实时换脸还要同时考虑速度、稳定性和画质
理解了两种工作流分别解决什么问题之后,就更容易看懂实时换脸为什么会多出一组特殊要求。
照片或离线视频没有严格的实时响应限制。一张照片可以多算一会儿;一段已经录好的视频也可以使用更重的处理、重复生成某些部分,甚至在后期继续修正。系统不需要因为“下一帧马上就来了”而立刻给出结果。
实时换脸则一直处在时间压力下。摄像头不断送来新的画面,如果处理速度跟不上,延迟会越来越明显,甚至出现掉帧或动作落后的感觉。
同时,快还不够。实时视频还需要保持前后稳定。假设每一帧单独看都不错,但人物身份、脸部边缘或五官细节不断轻微变化,播放起来还是会很不自然。这类前后画面保持一致的问题,在技术上通常称为时间一致性(temporal consistency)。
因此实时系统通常需要同时平衡几件事:
- 单帧画质是否足够好;
- 前后画面是否稳定;
- 动作和表情能不能及时跟上;
- 从摄像头输入到看到结果的整体延迟是否足够低。
这并不意味着传统换脸的画质一定更高,也不意味着实时换脸一定更差。最终效果仍然取决于模型、参考图、原始画面和具体处理方式。区别在于:实时系统必须把响应速度也当成核心指标,而离线处理拥有更多时间去追求最终成片。
怎么判断自己需要哪一种
可以用一个很简单的问题来判断:你的输入素材已经完成了吗?
如果你已经有一张照片或一段录好的视频,只想得到最终处理结果,那么照片换脸或上传视频换脸通常更合适。它们不需要承担实时延迟,可以把重点放在最终输出上。
如果你希望画面在你说话、转头、做表情或与别人互动的同时就发生变化,那么你真正需要的是实时换脸。
换句话说:
- 处理已经存在的素材 → 照片或上传视频换脸;
- 处理正在发生的画面 → 实时换脸。
这也是两类工作流最本质的分界线。