
过去提到实时换脸,很多人的第一反应是:先准备一张性能足够的 NVIDIA 显卡,再安装模型、CUDA 和一整套运行环境。
现在,这已经不是唯一的方式。
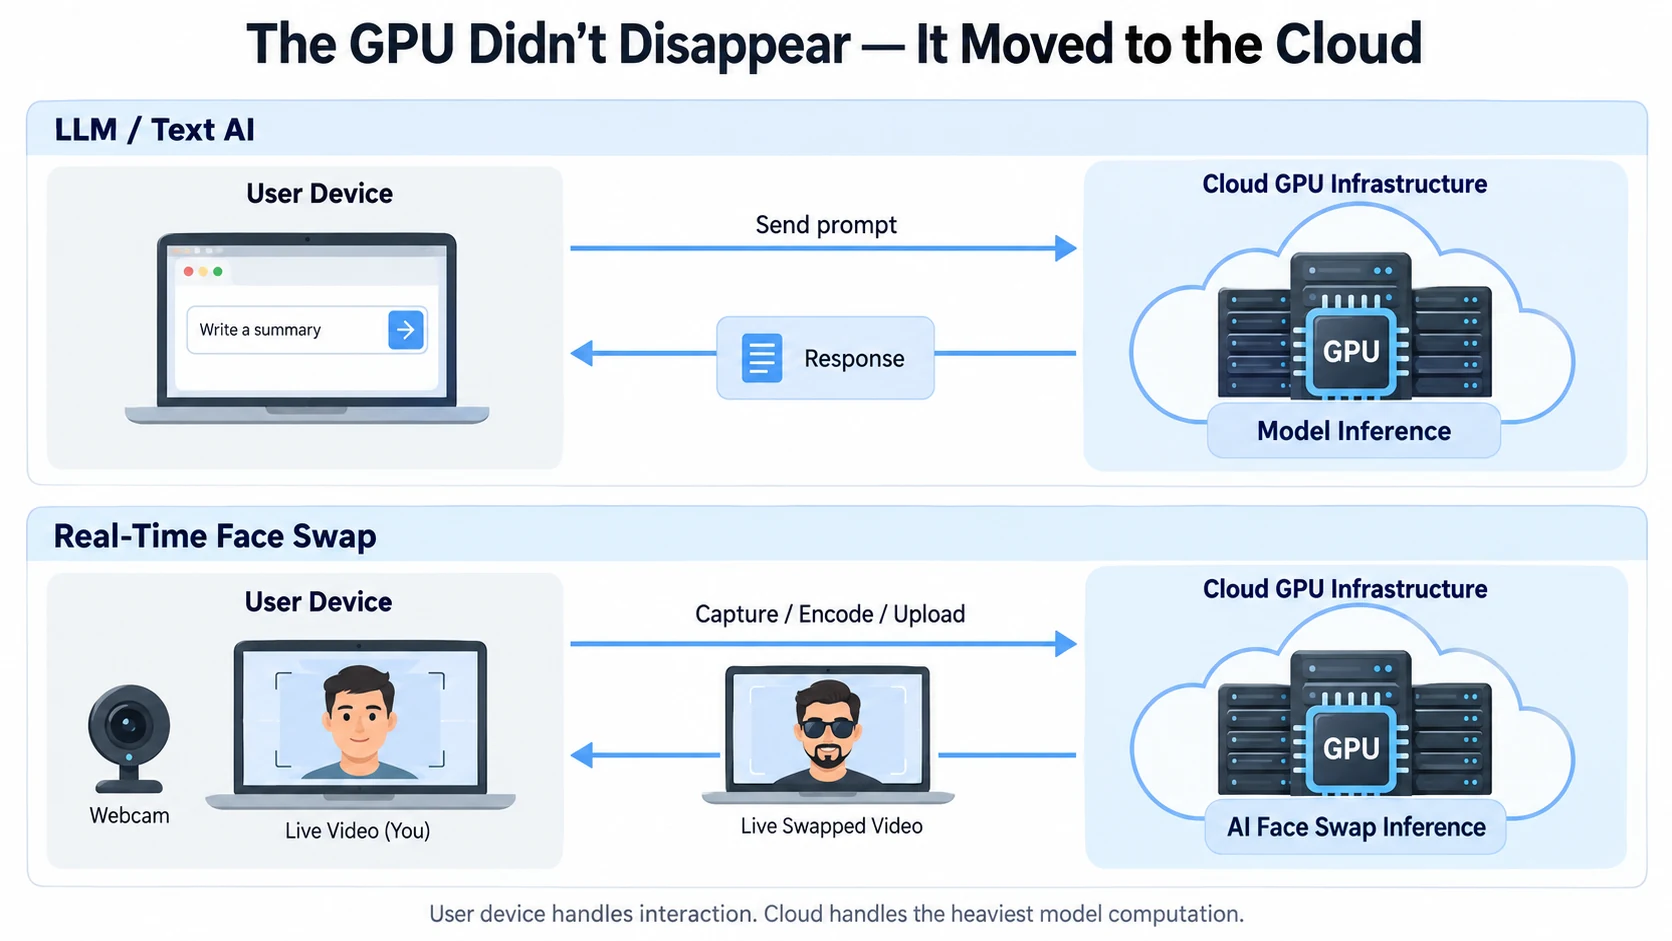
更准确地说,实时 AI 换脸并没有“不需要 GPU”,而是 GPU 正在从用户的电脑里移到云端。 这种变化并不只发生在换脸领域。今天很多主流大语言模型也是类似的模式:用户在浏览器或 App 里输入内容,真正消耗大量显存和算力的模型则运行在远程数据中心。
随着实时视频模型变得更复杂,实时换脸也越来越像这一类云端 AI 服务。
AI 早就在从个人电脑走向云端
大语言模型是最容易理解的例子。
小型模型当然可以在本地运行,但很多能力更强、规模更大的模型通常通过云端服务提供。原因并不神秘:模型越大,对显存、计算能力、推理框架和部署环境的要求越高。普通消费者显卡很难同时满足这些要求,更不用说还要持续升级模型版本。
于是,用户设备和 AI 模型之间的分工发生了变化。
用户的电脑主要负责:
- 输入和交互;
- 显示结果;
- 网络连接;
- 少量本地预处理。
而真正重的模型推理集中在云端 GPU 上。
这并不意味着本地 AI 会消失。小模型、隐私敏感场景、离线应用和高度定制化工作流仍然很适合本地运行。但对于希望直接打开网页或 App 就使用高算力 AI 的普通用户,云端已经成为很自然的架构。
实时换脸也开始出现同样的变化
实时换脸早期更像传统桌面 AI 软件:模型下载到本机,摄像头画面在本机处理,GPU 负责持续推理。
这种方式很直接。
摄像头 → 本地 GPU 推理 → 输出
但随着 AI 在实时视频里的作用越来越重,模型本身也在变得更复杂。更高的画面质量、更稳定的身份保持、更好的角度和表情处理,往往都意味着更多计算。
问题是,用户的电脑配置差异非常大。
有人有高端 NVIDIA GPU,有人只有集成显卡;有人使用 Windows 游戏电脑,也有人使用轻薄笔记本或 Mac。只要主要 AI 推理必须在本机完成,产品就必须面对不同显卡、驱动、显存、运行时和系统环境带来的兼容性问题。
把主要推理移到云端之后,这一部分差异就可以被集中处理。
为什么以前本地 GPU 是最自然的选择
实时视频和普通 AI 请求有一个明显区别:它不能慢慢等。
摄像头会持续产生新画面。每一帧都需要尽快完成处理,否则延迟会不断积累,最终让画面和人的动作明显不同步。
在网络基础设施和实时云端推理还不成熟的时候,把模型直接放在本机 GPU 上是最简单的低延迟方案。这样不需要把视频持续上传到服务器,也没有网络往返。
但代价也很明显:
- 用户必须拥有合适的硬件;
- 模型和依赖需要安装在本机;
- 驱动、CUDA、推理后端和版本兼容都可能成为问题;
- 如果同一块 GPU 还在运行游戏、OBS 或其他应用,可用算力会进一步下降。
如果你主要关心自己的电脑到底需不需要独立显卡,可以看实时换脸需要 GPU 吗?。那篇文章专门讨论 GPU、显存以及本地和云端推理的硬件差异。
GPU 没有消失,只是搬到了云端
云端实时换脸把架构换成了另一种形式:
摄像头 → 编码 → 网络 → 云端 GPU 推理 → 网络 → 解码与显示
本机仍然要完成摄像头采集、视频编码、网络通信和结果显示,但最重的 AI 推理不再占用用户自己的 GPU。
这带来一个很直接的变化:用户不再需要为了使用某个实时 AI 模型,先拥有能跑得动它的显卡。
模型可以部署在统一的服务器硬件上,服务端负责驱动、运行时、模型版本和扩容。用户看到的则更像今天使用 ChatGPT 或其他云端 AI 产品的体验:打开应用,建立连接,然后直接使用能力。
云端解决了硬件门槛,但带来了延迟问题
把模型移到云端并不是把问题消灭了,而是把主要问题换了一个位置。
本地推理最关心 GPU 是否足够快。云端推理除了模型速度,还要考虑完整链路:
采集 → 编码 → 上传 → 调度 → AI 推理 → 返回 → 解码 → 显示
其中任何一步变慢,都可能让实时体验受到影响。
网络抖动、服务器排队、编码速度和模型推理时间都会进入同一个延迟预算。这也是为什么实时 AI 视频产品不能只看“模型每帧需要多少毫秒”,而必须看从摄像头到最终显示的端到端时间。
所以,云端架构并不天然比本地更快。它最大的变化是把用户的硬件门槛转换成了服务商需要解决的网络、调度和基础设施问题。
如果你想进一步比较这两种方式在延迟、隐私、成本和维护上的区别,可以看云端 vs 本地实时换脸。
实时 AI 视频可能会越来越像今天的 LLM 产品
从更大的趋势看,实时换脸只是实时 AI 视频的一种应用。
当模型越来越复杂时,让每个用户自己下载、配置并维护完整 AI 环境,往往并不是最容易扩展的产品形态。云端可以集中部署更大的模型,也能让模型升级不再依赖用户重新安装整套环境。
这和大语言模型的发展路径很相似:
用户设备负责交互,云端负责最重的模型计算。
对于实时视频来说,难点比文本更高,因为视频需要持续传输,而且用户对延迟非常敏感。但只要云端推理、视频传输和 GPU 调度继续改善,越来越多实时 AI 能力都有可能采用这种分工。
本地推理仍然会存在,而且在离线、隐私和完全控制模型的场景里仍然有明显价值。云端化不是“取代本地”,而是让高算力实时 AI 不再只属于拥有高端硬件的人。
LiveFaceSwap AI 就是这种架构的一个实际例子
LiveFaceSwap AI 的浏览器版和 Desktop 都把主要实时 AI 推理放在云端。
这意味着用户不需要在自己的电脑上安装大型换脸模型、配置 CUDA,也不需要为了 AI 推理专门准备高性能独立显卡。浏览器可以直接用于实时预览;需要把结果送进 OBS、Zoom、Teams 或其他桌面软件时,则可以使用 Desktop 的虚拟摄像头。
这并不是因为实时换脸突然变成了“轻量任务”。
相反,背后的 GPU 计算仍然存在。只是像很多现代 AI 服务一样,它被集中到了云端,普通用户看到的不再是一套需要自己维护的 AI 环境,而是一项可以直接使用的实时服务。
这可能也是实时 AI 视频接下来最重要的变化之一:模型继续变重,但使用它们的设备不一定也要跟着变重。