实时换脸(Live Face Swap),是指摄像头或其他实时视频持续输入时,AI同步生成换脸后的动态画面。
它和普通照片换脸、上传视频换脸最大的区别,不是“能不能换脸”,而是画面会随着你的动作、表情和视角持续变化,你面对摄像头时就能看到结果。
实时换脸的输入和输出分别是什么?
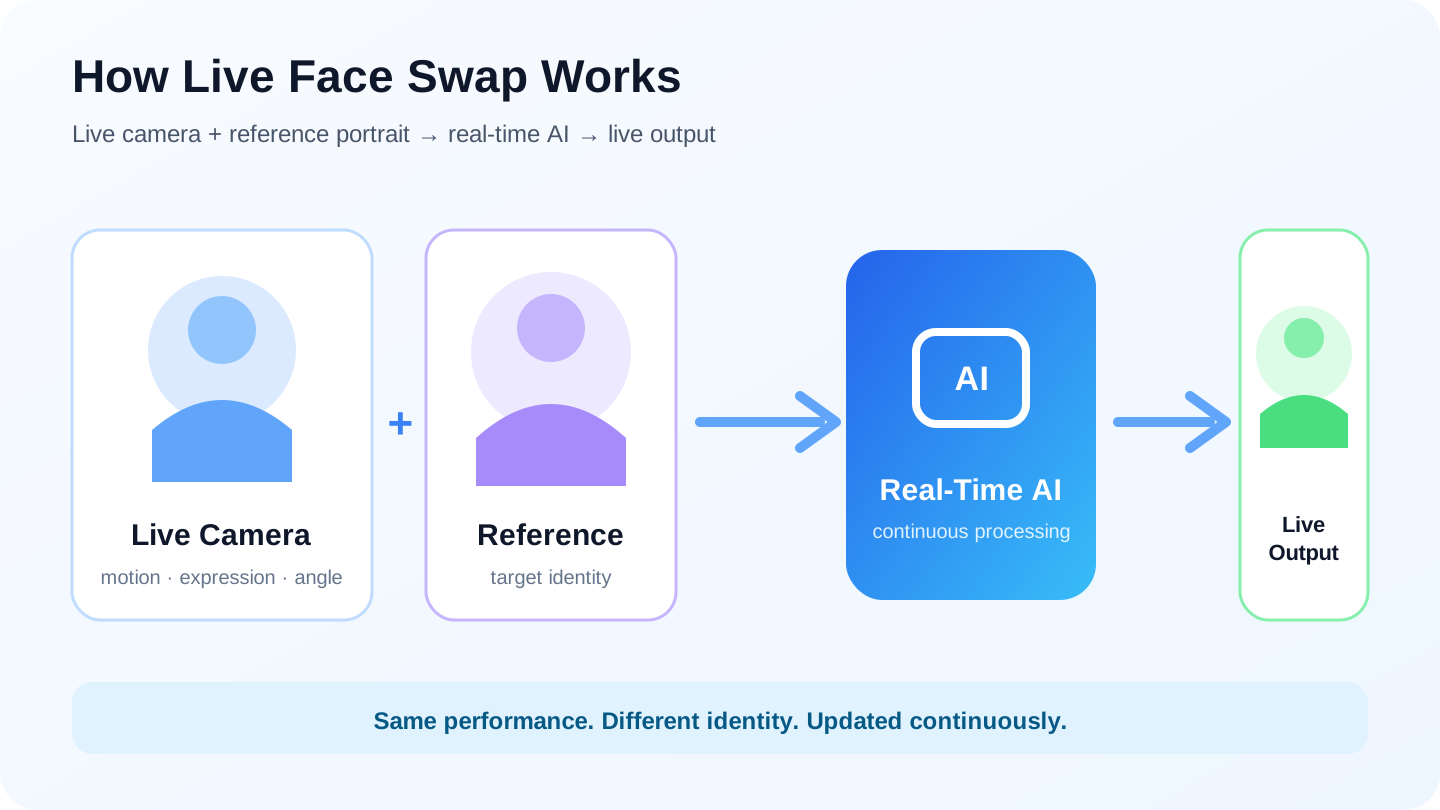
最常见的实时换脸需要两类输入:
- 实时摄像头画面: 提供你当前的动作、表情、头部角度和画面环境;
- 参考人像: 告诉AI希望画面中的人物呈现什么身份或外观。
系统持续处理摄像头画面,再输出不断更新的AI视频。
可以把整个过程先简单理解成:
摄像头画面 + 参考人像 → 实时AI处理 → 换脸后的动态画面
你本人仍然在镜头前说话、转头、眨眼和做表情。换掉的是画面中的身份或外观,动作和表情则尽量跟着你本人保持同步。
它为什么叫“实时”?
“实时”最关键的地方,是不需要先把素材录完,再上传等待处理。
当你转头、改变表情或靠近摄像头时,AI输出也会继续更新。你可以当场看到动作发生后,换脸结果是怎样跟随变化的。
这和传统的离线流程很不一样:
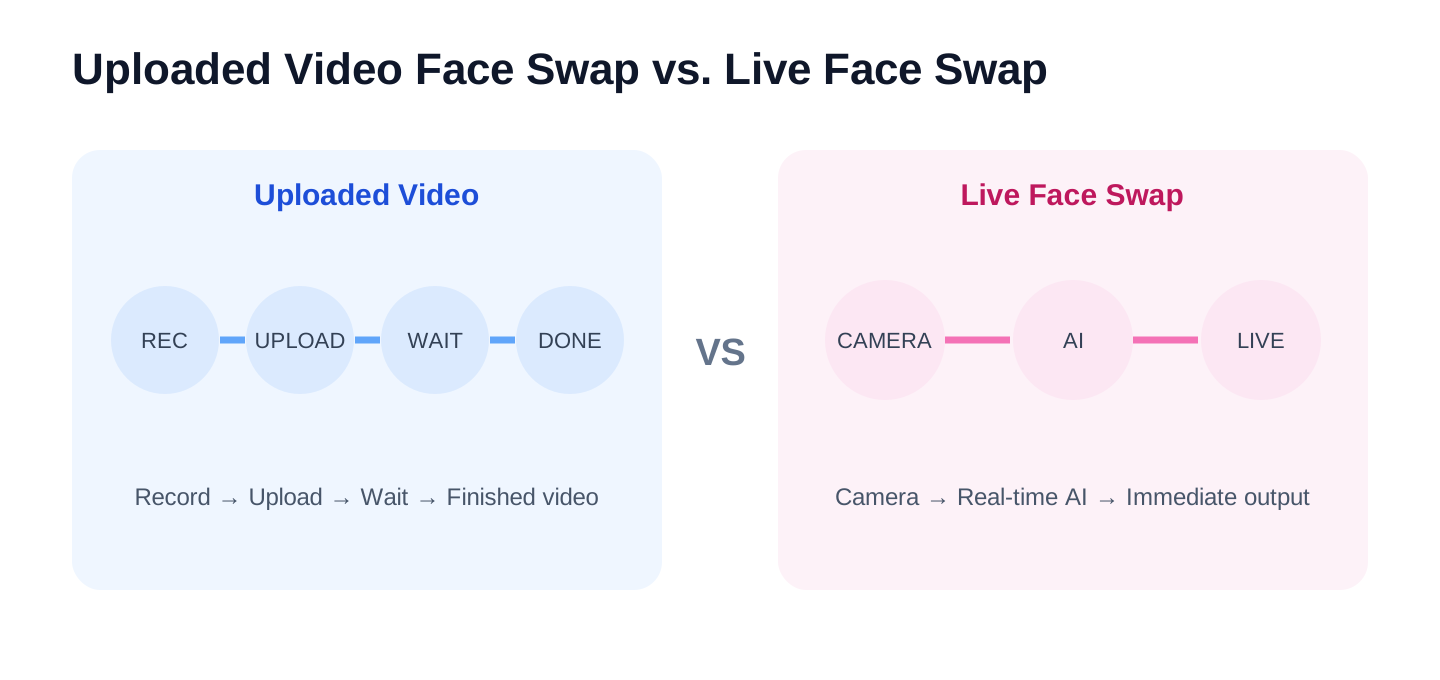
录制视频 → 上传 → 等待处理 → 查看或下载结果
实时换脸则更接近:
摄像头正在工作 → AI持续处理 → 同时看到结果
因此,如果一个工具必须先录制或上传视频,再等待生成结果,这属于视频换脸,但通常不算真正意义上的实时换脸。
实时换脸和照片换脸有什么区别?
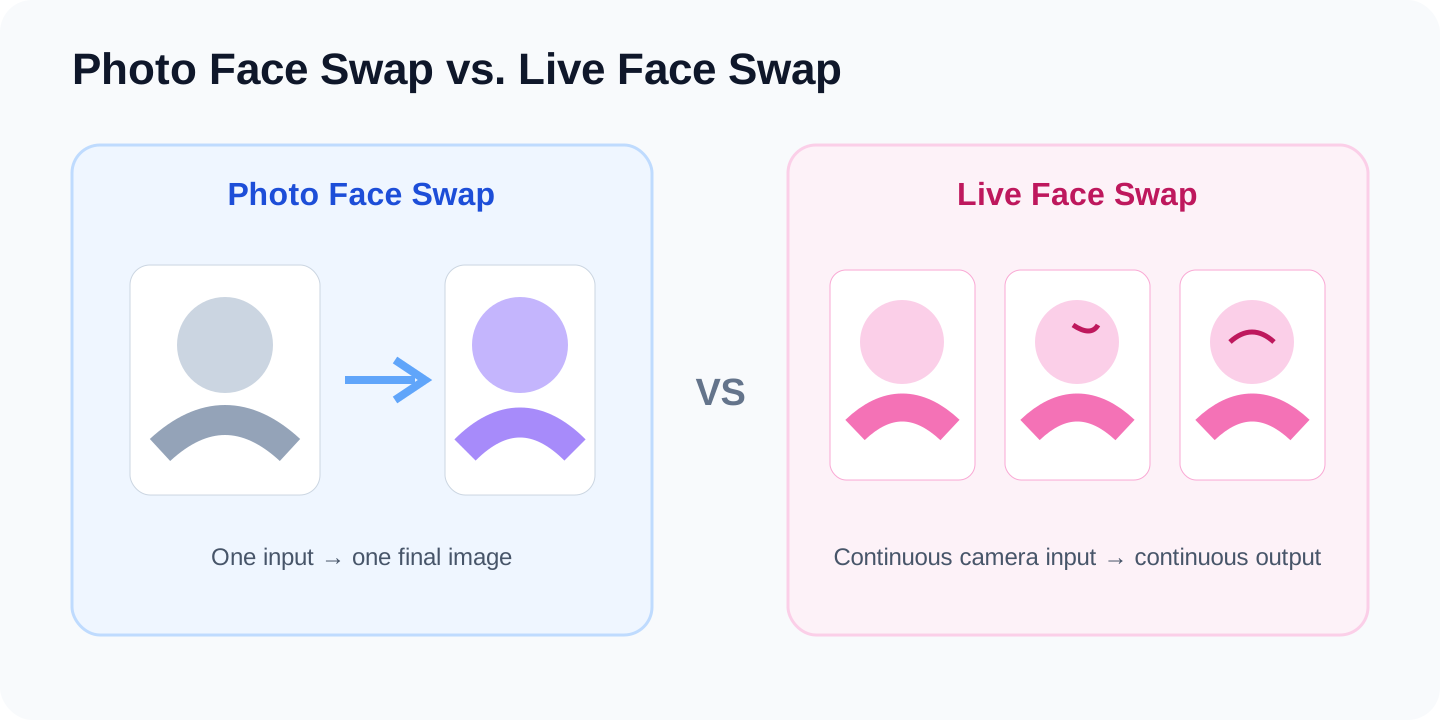
照片换脸只需要处理一个静态画面。实时换脸处理的是连续发生的视频。
| 对比项 | 照片换脸 | 实时换脸 |
|---|---|---|
| 输入 | 静态图片 | 持续的视频画面 |
| 输出 | 一张结果图 | 持续变化的视频 |
| 是否需要跟随动作 | 不需要 | 需要 |
| 延迟是否重要 | 通常不重要 | 很重要 |
| 连续稳定性是否重要 | 不重要 | 很重要 |
一张照片只需要最终结果看起来正确。实时换脸则要面对不断变化的转头、表情、说话、距离和遮挡,而且前后画面不能频繁跳变。
所以,“照片换得像”并不能直接说明一个系统适合实时摄像头换脸。
实时换脸和上传视频换脸有什么区别?
上传视频换脸同样会处理很多帧,但它可以在视频录制完成之后慢慢计算。
典型流程是:
先录制 → 上传视频 → 等待处理 → 获得成片
实时换脸没有这段等待环节。人在镜头前说话或移动时,系统就需要持续生成并输出结果。
因此:
能处理视频,不等于能处理实时摄像头。
对于直播、视频通话或现场互动来说,这个区别尤其重要,因为画面必须在互动发生时就可用,而不是几分钟之后才生成。
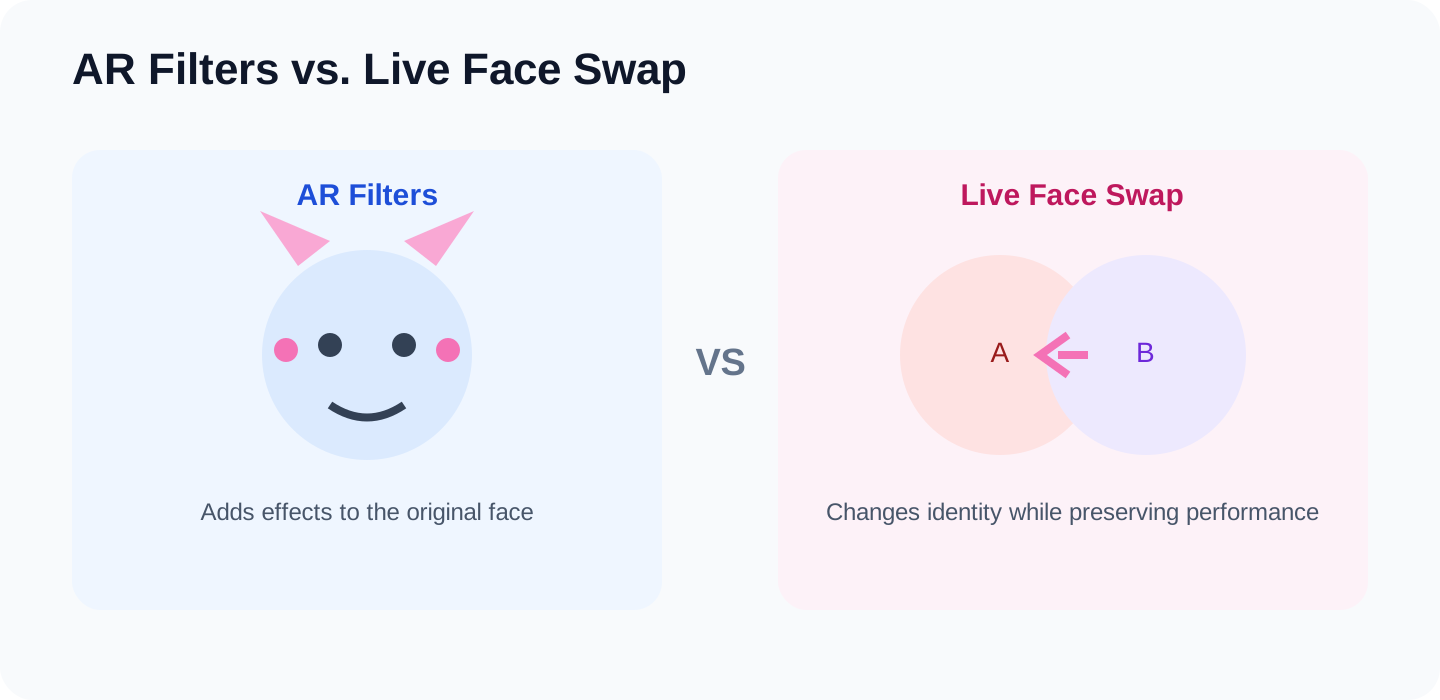
实时换脸和滤镜有什么区别?
传统AR滤镜通常是在原始脸部上增加或修改一些视觉元素,例如:
- 美颜;
- 面具;
- 动物耳朵;
- 贴纸;
- 妆容;
- 简单的脸型变化。
实时AI换脸更关注的是改变画面中的人物身份,同时尽量保留原本的动作、表情和镜头视角。
两者都可以实时运行,但解决的问题不同:滤镜通常是在“原来的你”上增加效果;换脸则是在保留动作的同时改变人物身份或外观。
现在一些实时生成式视频系统已经不只修改脸部,还能改变头发、服装甚至整体视觉风格,因此实时换脸和更广义实时AI视频处理之间的界限也在逐渐变得模糊。
实时换脸和 VTuber / AI Avatar 是一回事吗?
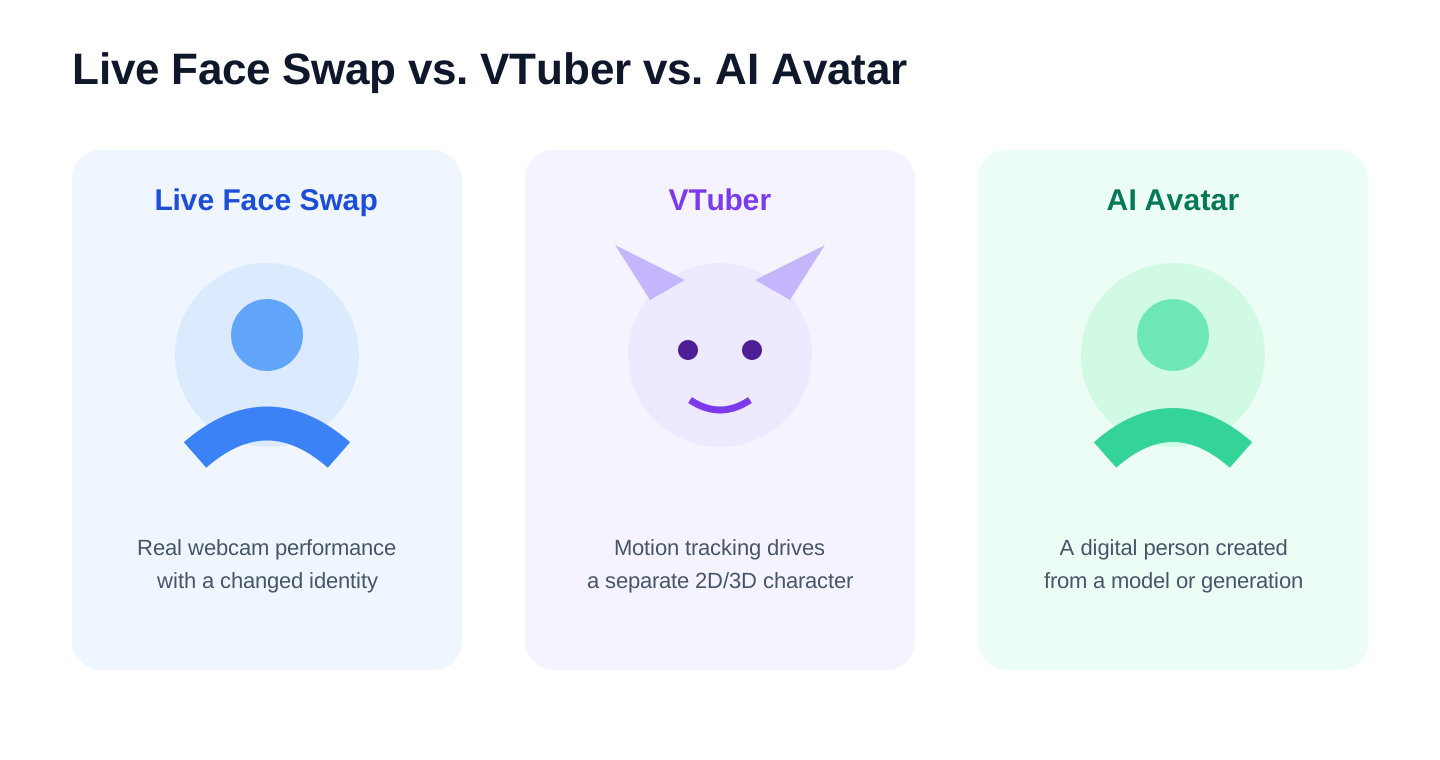
不是一回事,但它们都可以让一个人以不同的视觉身份出现在镜头前。
传统VTuber通常是:
你的动作和表情 → 驱动一个独立的2D或3D角色模型
实时换脸则更接近:
保留当前真人摄像头中的动作和画面 → 改变人物身份或外观
所以,VTuber画面通常来自一个单独绘制或建模的角色;实时换脸仍然以摄像头中的真人视频为基础。
它们没有谁天然更“高级”,只是生成画面的方式和最终视觉效果不同。
实时换脸通常用来做什么?
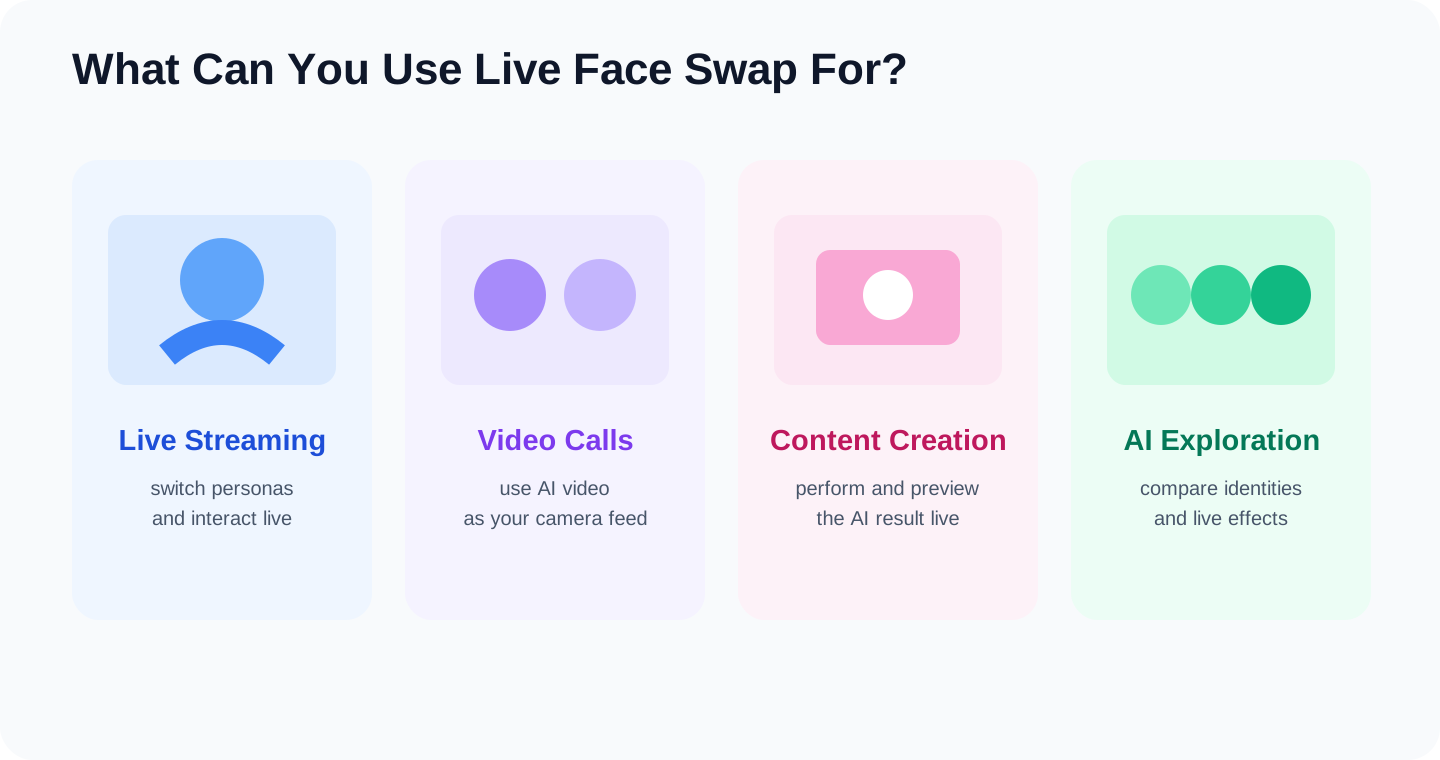
常见用途包括:
- 直播中的人物或角色变化;
- 视频通话里的实时AI画面;
- 短视频和角色内容创作;
- 虚拟角色表演;
- AI效果体验和创意实验。
这些场景有一个共同点:画面的变化需要和人的动作、说话或互动同时发生。
如果想具体了解每一种场景怎么使用,可以继续看现在的实时换脸可以用来做什么?。
实时换脸需要安装软件或高性能显卡吗?
不一定。
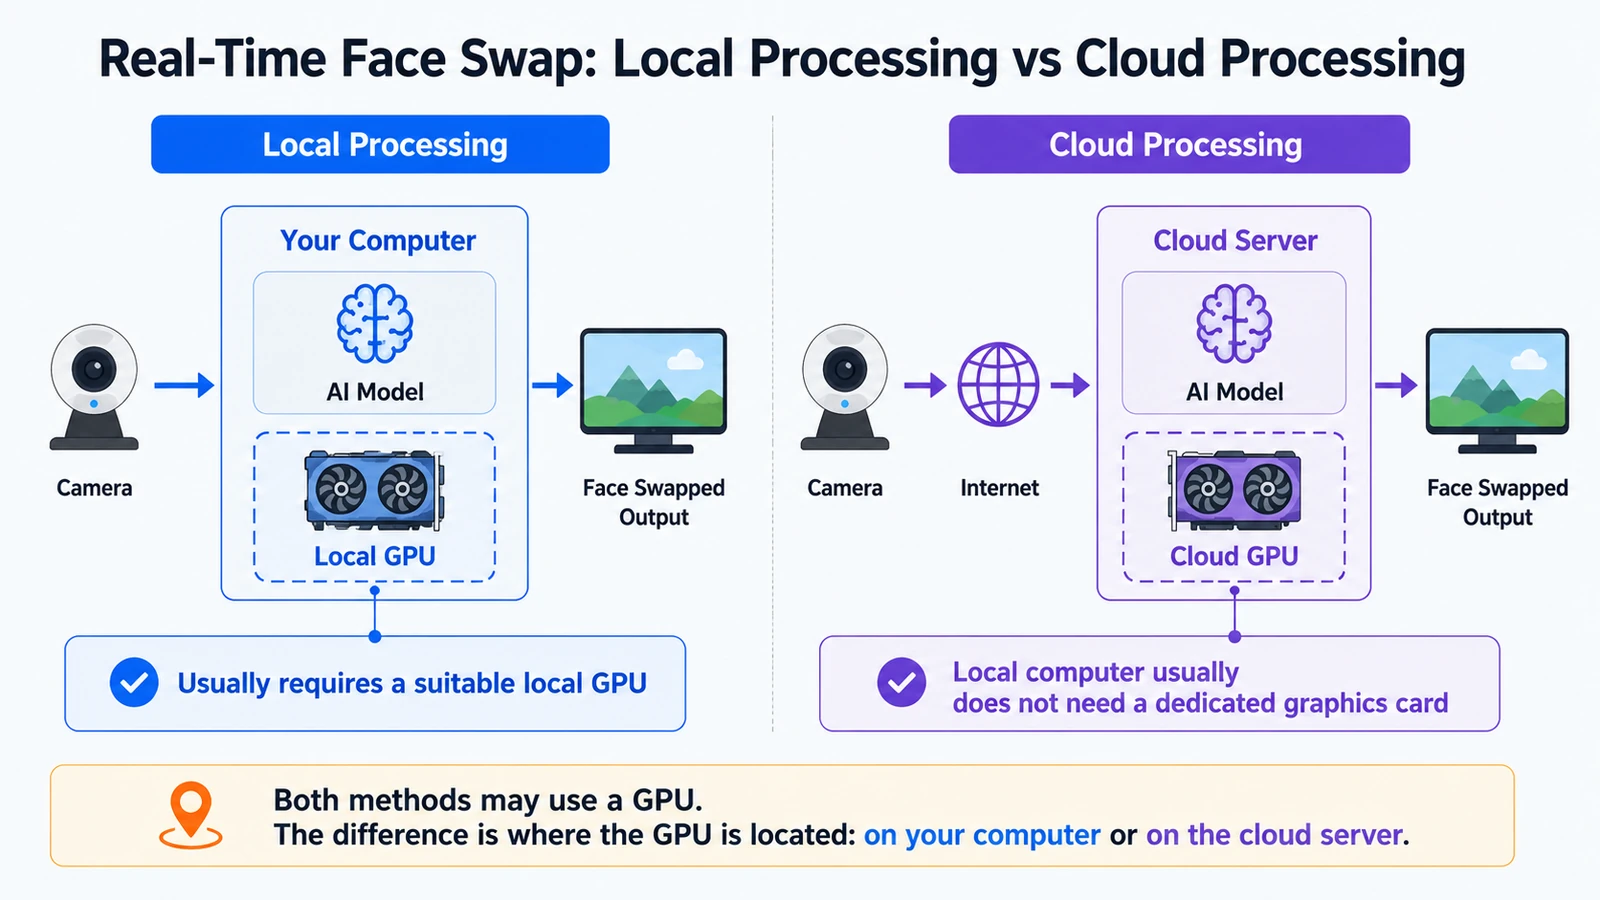
实时换脸既可以在本地运行,也可以把主要AI处理放到云端。
- 本地方案: AI模型直接在本地设备运行,通常更依赖本机GPU、驱动和软件环境;
- 云端方案: 摄像头画面发送到云端完成主要AI处理,本地不一定需要高性能独立GPU。
LiveFaceSwap采用云端实时AI处理,因此网页版和LiveFaceSwap Desktop都不要求用户为了AI推理准备高性能独立显卡。
如果你更关心不同方案的硬件要求,可以继续看AI实时换脸需要显卡吗?。